Event
BRISA Reading Group 06 - Long-WAM: Scaling the Context of World-Action Models
Der sechste Lesekreis von BRISA, der Berlin Robotics & Intelligent Systems Association, am Merantix AI Campus: Besprochen wurde Long-WAM, ein Paper darüber, wie viel visuelle Vorgeschichte ein World-Action-Modell für die Echtzeit-Robotersteuerung nutzen kann.
- Event
- Robotik
- KI
- Weltmodelle
- Art
- Event
- Datum
- 16. November 2026
- Ort
- Berlin, Deutschland
- Lesezeit
- 6 Min.
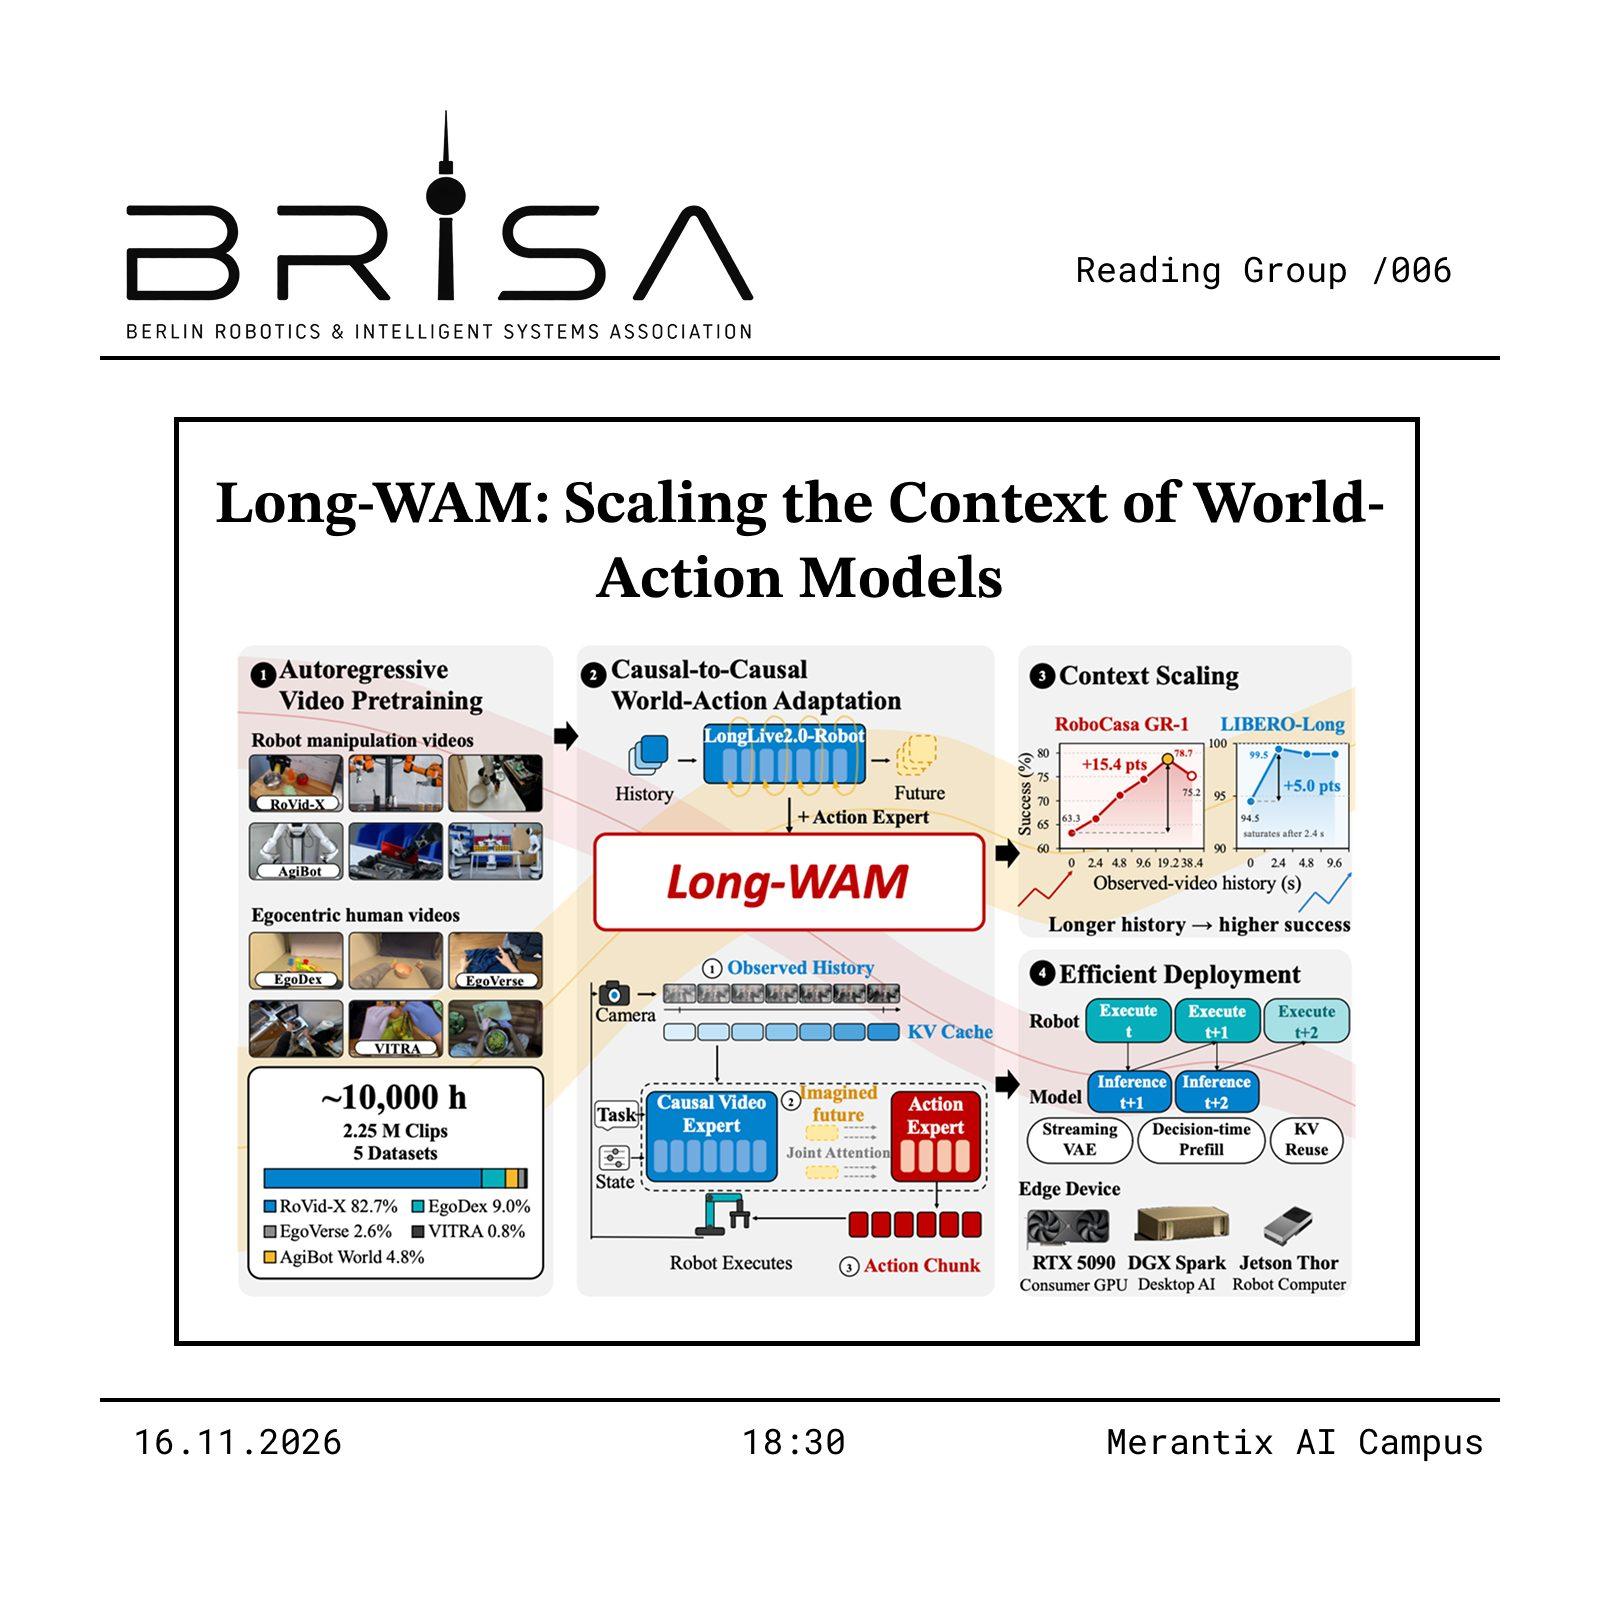
Am 16. November 2026 war ich bei der BRISA Reading Group 06 am Merantix AI Campus in Berlin. Den Lesekreis organisiert BRISA, die Berlin Robotics & Intelligent Systems Association, die als Ziel nennt, die Zukunft der Physical AI in Berlin aufzubauen. Als Gastgeber führt die Eventseite BRISA, den Merantix AI Campus und Myron Sydorov, VP bei BRISA. Einlass war um 18:30 Uhr, los ging es um 18:45 Uhr, das Ende war für 20:00 Uhr geplant. Die sechste Ausgabe drehte sich um ein einziges Paper: Long-WAM, über die Frage, wie viel Vergangenheit das World-Action-Modell eines Roboters tatsächlich nutzen kann.
Warum ich dort war
Weltmodelle und Robot Learning liegen nah an meinem eigenen Feld, der Simulation: Ein World-Action-Modell sagt voraus, wie sich eine Szene entwickelt, bevor es handelt. Ein Lesekreis passt gut zu dem Thema, weil es um ein einziges Paper und die Diskussion darüber geht. Außerdem wollte ich die Leute kennenlernen, die in Berlin an Physical AI arbeiten, mich mit ihnen austauschen und herausfinden, wo meine nächsten Schritte in diesem Bereich liegen könnten.
Was ich gesehen habe
Die Eventseite erklärte das Problem hinter dem Paper. Ein Roboter, der nur das aktuelle Bild sieht, kann nicht erkennen, ob sich die Tasse vor ihm bewegt oder wie weit er mit seiner Aufgabe schon ist. Mehr visuelle Vorgeschichte scheint die naheliegende Lösung, doch Vorgeschichte kostet Zeit, und ein Roboter, der zu lange nachdenkt, handelt zu spät.
- Das Thema World-Action-Modelle sagen voraus, wie sich eine Szene entwickeln wird, und handeln auf Basis dieser Vorhersage, statt Bilder direkt auf Aktionen abzubilden. Die Frage des Abends: Wie viel Vergangenheit kann so ein Modell nutzen?
- Das Format Keine Vorbereitung nötig, offen für alle, egal was und wo sie studieren und wie viel Robotik sie bisher gemacht haben. Die Plätze waren begrenzt, damit die Runde persönlich und interaktiv bleibt; die Seite zeigt 33 angemeldete Gäste.
- Die Einladung Mitbringen sollte man Fragen, Widerspruch oder eine eigene Schätzung, wie viele Sekunden Vergangenheit sich ein Roboter merken sollte.
Das besprochene Paper
Long-WAM: Scaling the Context of World-Action Models von Wei Huang, Bohan Zhang, Chenzhi Liu, Isabella Liu, Shuai Yang, Weian Mao, Luozhou Wang, Yicheng Xiao, Weifeng Lin, Qixin Hu, Bryan Chu, Sifei Liu, Linxi Fan, Xiaojuan Qi, Song Han und Yukang Chen, von NVIDIA, MIT, HKU und UCSD. Es wurde am 7. Oktober 2026 auf arXiv eingereicht, der Code ist öffentlich.
Die Frage. Echtzeit-Robotersteuerung braucht genug visuelle Vorgeschichte, um Bewegung und Aufgabenfortschritt zu erkennen, doch das Verarbeiten dieser Vorgeschichte kann die Aktion verzögern. Die Autoren fragen, wie die Steuerung mit einem World-Action-Modell (WAM) mit dem visuellen Kontext skaliert und wie sich diese Gewinne unter Echtzeitbedingungen halten lassen.
Die Methode. Das Paper verbindet ein Trainingsrezept mit einem System für den Einsatz:
- Autoregressives Video-Vortraining LongLive2.0-Robot setzt auf dem Videomodell LongLive-2.0 auf und lernt, Videos aus Roboter- und Egoperspektiv-Aufnahmen von Menschen vorherzusagen: rund 10.000 fensteräquivalente Stunden aus fünf Datensatzfamilien, Sequenzen bis 30 Sekunden, ohne Aktionslabels.
- Kausal-zu-kausal-Anpassung Ein Video-Experte und ein Aktions-Experte sind so gekoppelt, dass Video-Tokens nur auf aktuelles und früheres Video schauen, nie auf Aktionen. Bei der Inferenz sagt das Modell zuerst in vier Entrauschungsschritten zukünftige Latents vorher, dekodiert sie nie zu Pixeln und entrauscht dann einen Aktionsblock, bedingt auf die beobachtete Vorgeschichte und diese vorhergesagte Zukunft.
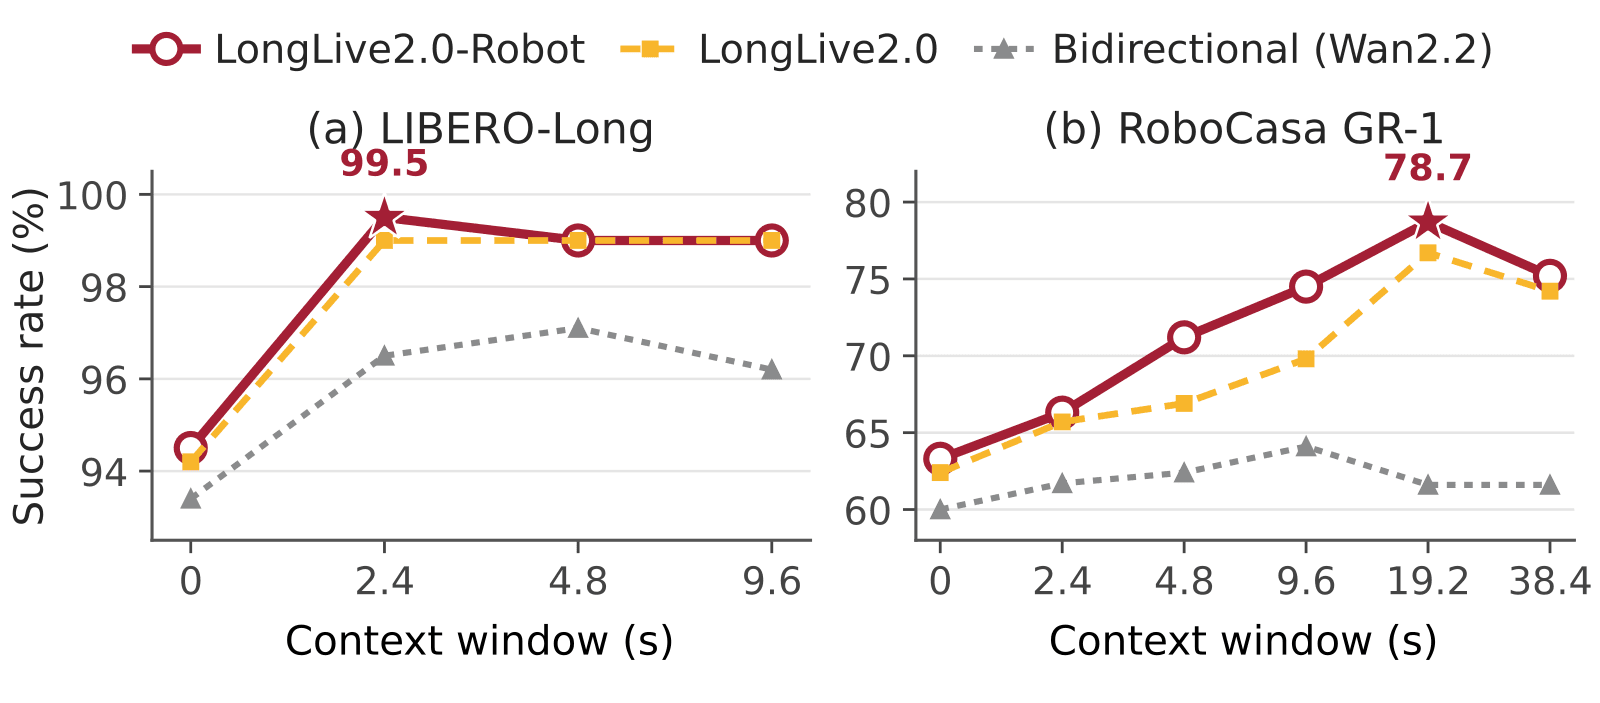
- Kontext-Skalierung Die Länge der echten Vorgeschichte wird variiert (0 bis 38,4 Sekunden auf RoboCasa GR-1, 0 bis 9,6 Sekunden auf LIBERO-Long), Vorhersage- und Aktionshorizont bleiben fest, für jedes Fenster wird ein eigenes Modell trainiert. Verglichen werden drei Ausgangspunkte: Wan2.2 (bidirektional vortrainiert), LongLive-2.0 und LongLive2.0-Robot (beide autoregressiv).
- Echtzeit-Einsatz Asynchrone Ausführung überlappt Inferenz und Roboterbewegung, ein Streaming-VAE kodiert Bilder, sobald sie ankommen, und 4-Bit-Quantisierung des Video-Experten mit NVFP4, CUDA Graphs, KV-Wiederverwendung und gerätespezifisches Kernel-Tuning beschleunigen die Inferenz auf einer RTX 5090, einem DGX Spark und einem Jetson AGX Thor.
Die Ergebnisse, wie das Paper sie angibt:
- Kontext braucht das passende Vortraining Auf RoboCasa GR-1 steigt die Erfolgsquote von 0 auf 19,2 Sekunden Vorgeschichte von 63,3 % auf 78,7 %. Der bidirektional vortrainierte Ausgangspunkt gewinnt unterm Strich nichts, sein Abstand zum Robotik-Modell wächst daher von 3,3 Punkten ohne Vorgeschichte auf 17,1 Punkte. Auf LIBERO-Long heben 2,4 Sekunden Vorgeschichte die Erfolgsquote von 94,5 % auf 99,5 %. Als Erklärung bieten die Autoren eine plausible Vermutung an, keinen Beweis: Autoregressives Vortraining lernt bereits die Struktur von Vergangenheit zu Zukunft, die das Aktionsmodell beibehält.
- Benchmarks 99,5 % im Schnitt auf LIBERO, 94,4 % auf RoboTwin 2.0 und 34,9 % auf DOMINO mit bewegten Objekten, jeweils der beste Wert unter den verglichenen Methoden. Die 78,7 % auf GR-1 liegen 11,6 Punkte über der stärksten Baseline im Paper. Zusammen mit einem übergeordneten Planer steigt die Gesamtquote auf RoboCasa365 von 31,4 % auf 54,4 %, gegenüber 25,2 % für den Planer allein.
- Geschwindigkeit Ein Aktionsblock samt Zukunftsvorhersage dauert auf einer RTX 5090 107,4 ms, 3,3-mal schneller als unoptimiertes BF16; der DGX Spark kommt auf 328,2 ms, der Jetson AGX Thor auf 378,7 ms. Bei asynchroner Ausführung verliert Long-WAM auf RoboTwin 2.0 0,2 Punkte, Fast-WAM 15,4 und LingBot-VA 45,5.
- Echte Roboter Auf einem Unitree G1 bleibt das Greifen von Tassen vom Förderband bei Bandgeschwindigkeiten von 3,0 bis 7,5 cm/s bei 90 bis 100 %, während Fast-WAM von 75 % auf 0 % fällt und π0.5 von 15 % auf 0 %. Das Stapeln einer bewegten Tasse gelingt in 19 von 20 Versuchen; keine der beiden Baselines schafft es ein einziges Mal. Auf einem zweiarmigen YAM gelingen Aufgaben, die im Schnitt über 40 Sekunden dauern, in 81,7 % der Versuche.
Die Einschränkungen, die die Autoren selbst nennen:
- Jedes Kontextfenster ist ein eigenes trainiertes Modell. Eine einzige Policy, die ihr Fenster zur Laufzeit anpasst, nennen sie als nächsten Schritt.
- Vorgeschichte hat ihren Preis: Von 2,4 auf 19,2 Sekunden steigt die Latenz auf der RTX 5090 von 107,4 auf 341,0 ms (74,6 ms ohne Vorgeschichte).
- Bei 38,4 Sekunden fällt die Erfolgsquote auf 75,2 % zurück. Dieses Fenster ist dreimal so lang wie die durchschnittliche Trainingstrajektorie von 12,1 Sekunden, und 80,4 % seiner Vorgeschichte-Frames sind Auffüllung; die Autoren vermuten fehlende Daten statt einer Gedächtnisgrenze.
- Die Kontextstudie läuft in der Simulation; Studien zur Kontextlänge an echten Robotern stehen noch aus. Die Trends begründen weder ein Potenzgesetz noch ein festes optimales Fenster.
- Die 10.000 Stunden sind eine fensteräquivalente Schätzung, kein einzigartiges Rohmaterial, und die Übertragung auf einen unbekannten Roboterkörper bräuchte eine eigene Evaluation.
Was ich mitnehme
Vor allem hat der Abend mein Verständnis einer Technologie vertieft: World-Action-Modelle und den Zielkonflikt zwischen der Menge an Vorgeschichte, die ein Roboter nutzt, und der Geschwindigkeit, mit der er handeln kann. Dass mehr Kontext nur mit dem passenden Pretraining etwas bringt und jede zusätzliche Sekunde Vorgeschichte Latenz kostet, nehme ich mit. Außerdem habe ich mein Netzwerk in der Berliner Robotik-Community erweitert.
Weiterlesen
Alle Beiträge- Event · 13. November 2026 · Berlin, Deutschland
Unicon 2026: Startup- und KI-Konferenz an der CODE in Berlin
Unicon 2026 war eine zweitägige, kuratierte Startup- und KI-Konferenz für rund 300 Studierende, Gründer und Investoren, ausgerichtet an der CODE University of Applied Sciences in Berlin-Neukölln am 13. und 14. November 2026.
- Event · 17. November 2026 · Berlin, Deutschland
GTM Engineering Meetup: Agents in Production
Ein Abend-Meetup während der GTM Tech Week Berlin mit Vorträgen und Live-Demos zu KI-Agenten, die im Go-to-Market im Alltag laufen.